
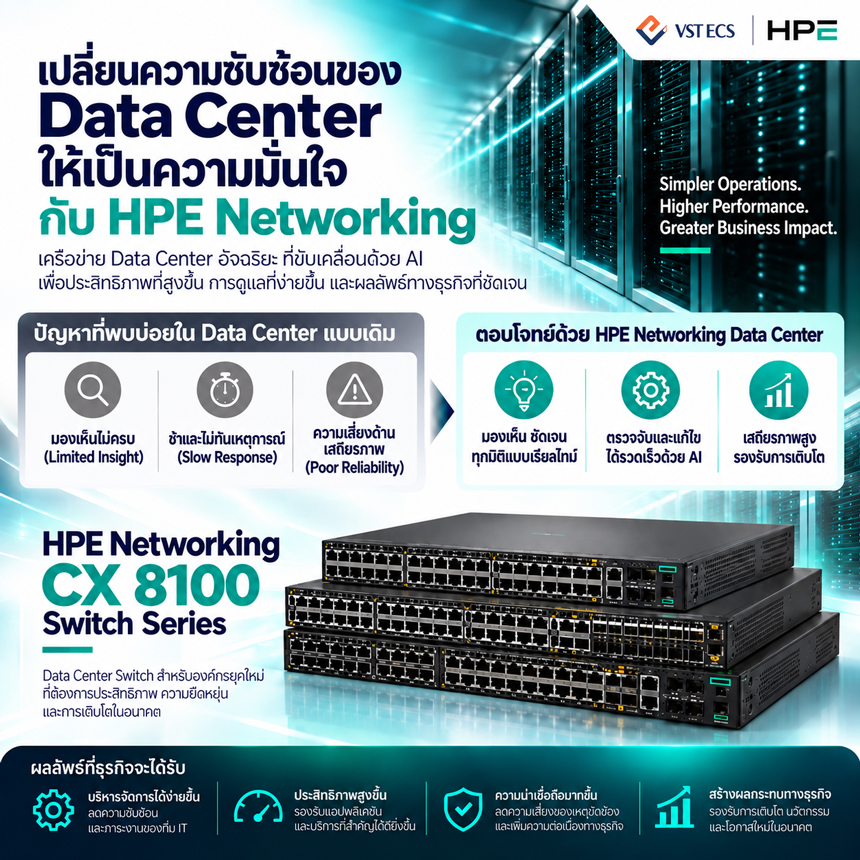
จาก Intent-Based Networking สู่ Self-Driving DC Networks ด้วย AI ที่ช่วยให้มองเห็น วิเคราะห์ คาดการณ์ และแก้ไขปัญหาได้อย่างชาญฉลาด
ในยุคที่แอปพลิเคชันและ Workload กลายเป็นหัวใจของธุรกิจ เครือข่าย Data Center ไม่ได้มีหน้าที่เพียง “เชื่อมต่อให้ติด” อีกต่อไป แต่ต้องรองรับความเร็ว ความต่อเนื่องและประสบการณ์ของผู้ใช้งานได้อย่างสม่ำเสมอ ขณะเดียวกันทีม IT ต้องรับมือกับโครงสร้างพื้นฐานที่ซับซ้อนขึ้น ข้อมูลจำนวนมหาศาล และความคาดหวังในการแก้ไขปัญหาที่รวดเร็วกว่าเดิม
HPE มองความท้าทายหลักของ Data Center Networking ไว้ 3 ด้าน ได้แก่
Limited Insight เมื่อเครื่องมือแบบเดิมมองเห็นเพียงสถานะอุปกรณ์แต่ไม่สะท้อนคุณภาพประสบการณ์จริง
Insufficient Speed เมื่อความซับซ้อนทำให้การเปลี่ยนแปลงหรือเพิ่ม Capacity ใช้เวลานาน
Poor Reliability เมื่อการตรวจพบปัญหาหลังเกิดเหตุไม่เพียงพอต่อระบบที่ต้องทำงานอย่างต่อเนื่อง
แนวทางของ HPE Networking Data Center จึงผสาน Intent-Based Networking จาก HPE Networking Data Center Director เข้ากับ AI-Native Operations และ Data Center Assurance เพื่อเชื่อมโยง Business Intent เข้ากับสถานะจริงของเครือข่าย ใช้ Contextual Graph Database ทำความเข้าใจความสัมพันธ์ของข้อมูล และตรวจสอบ Configuration ก่อนและหลังการ Deploy เพื่อเพิ่มความมั่นใจในการทำ Automation
Journey to Self-Driving DC Networks
หัวใจสำคัญคือการพัฒนาเครือข่ายจากการ “มองเห็นข้อมูล” ไปสู่การ “ลงมือแก้ไขได้อย่างอัตโนมัติ” โดยเพิ่มคุณค่าของข้อมูลในแต่ละขั้น ตั้งแต่ Data, Insights, Recommendations, Assisted ไปจนถึง Self-driving ที่ใช้ Agentic AI และ Auto-remediation
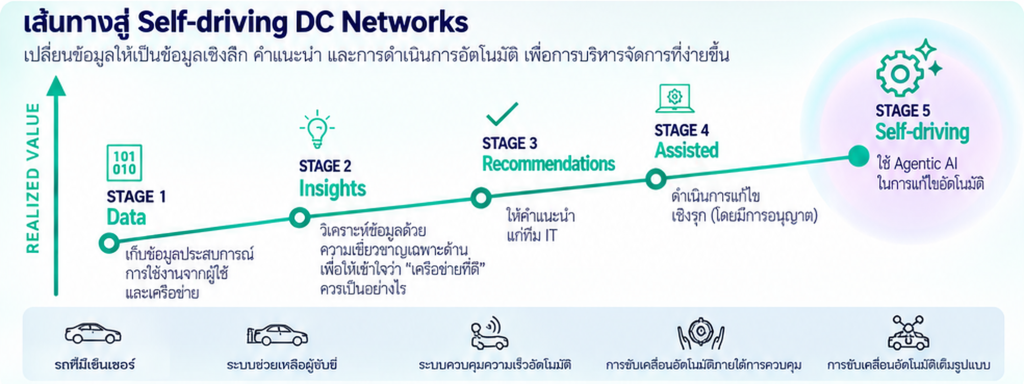
เส้นทางสู่ Self-Driving DC Networks: จากข้อมูลและ Insight สู่การช่วยแก้ไขเชิงรุกและ Auto-remediation
4 ความสามารถสำคัญที่ทำให้ HPE Networking Data Center แตกต่าง
1. Intent-Based Networking Contextual Graph Database เชื่อมโยงความต้องการทางธุรกิจกับสถานะ Physical และ Logical ของเครือข่าย พร้อม Validated Automation ที่ตรวจสอบ Configuration ก่อนและหลังการใช้งาน และสร้าง Contextual Data คุณภาพสูงสำหรับ AI และ Root Cause Analysis
2. Superior User and Application Experience Service Level Expectations (SLEs) เปลี่ยนการ Monitoring จากการดูเพียง Up/Down ไปสู่การวัดคุณภาพประสบการณ์จริง ครอบคลุม System, Link, Fabric, Virtual Infrastructure และ Service Health เพื่อให้ทีม IT เห็นสิ่งที่มีผลต่อผู้ใช้และแอปพลิเคชัน
3. Application Awareness and Impact Analysis เชื่อมโยง Application เข้ากับ Network Fabric เพื่อเข้าใจการสื่อสารและทรัพยากรที่ใช้ พร้อมวิเคราะห์ว่า Network Anomaly ใดส่งผลต่อ Application Performance ช่วยลด Troubleshooting Cycle, Alert Fatigue และเร่ง MTTR
4. Unified AI-Native Operations Marvis Actions ช่วยรวบรวมและจัดลำดับ Anomaly จาก Campus, Branch และ Data Center ไว้ในมุมมองเดียว พร้อมระบุ Root Cause เช่น Cable, VLAN หรือ Optic ที่มีปัญหา ขณะที่ Predictive Analytics และ Agentic AI ช่วยขยับการทำงานจาก Reactive ไปสู่ Proactive Operations
เมื่อข้อมูลเครือข่ายแอปพลิเคชันและ AI ทำงานบนบริบทเดียวกันองค์กรสามารถลดความซับซ้อนและงาน Manual, ยกระดับประสบการณ์ของผู้ใช้และ Application, คาดการณ์ปัญหาและดำเนินการเชิงรุกก่อนเกิด Outage รวมถึงเร่งการวิเคราะห์ Root Cause และการแก้ไขปัญหาให้รวดเร็วยิ่งขึ้น เป้าหมายปลายทางคือ Data Center ที่มีความน่าเชื่อถือสูงขึ้น พร้อมรองรับ Mission-Critical Workloads และการเติบโตของธุรกิจในอนาคต